Diese Seite beschreibt Funktionen, die von einem Administrator von eScriptorium eingerichtet werden: Standardmerkmale, die pro Instanz konfiguriert werden, sowie eine Erweiterung, die die Instanz der UB Mannheim über das Standard-Release hinaus bietet.
Inhalt
- 1. Transkriptionsschriftarten einrichten
- 2. Benutzer einladen
- 3. API-Token und REST-API
- 4. Web-Statistik (Matomo)
- 5. Wartungsbefehle (manage.py)
- 6. Celery-Queues und Worker
1. Transkriptionsschriftarten einrichten
Die Schriftart, mit der die Transkriptionszeilen im Bearbeitungsfenster angezeigt werden, ist in eScriptorium ein Standardmerkmal, das auf Dokument-, Projekt- oder Benutzerebene gewählt wird (siehe neues Interface, Abschnitt 1.12). Welche Schriftarten dabei zur Auswahl stehen, richtet der Administrator der Instanz ein.
1.1. Übersicht der Schriftarten
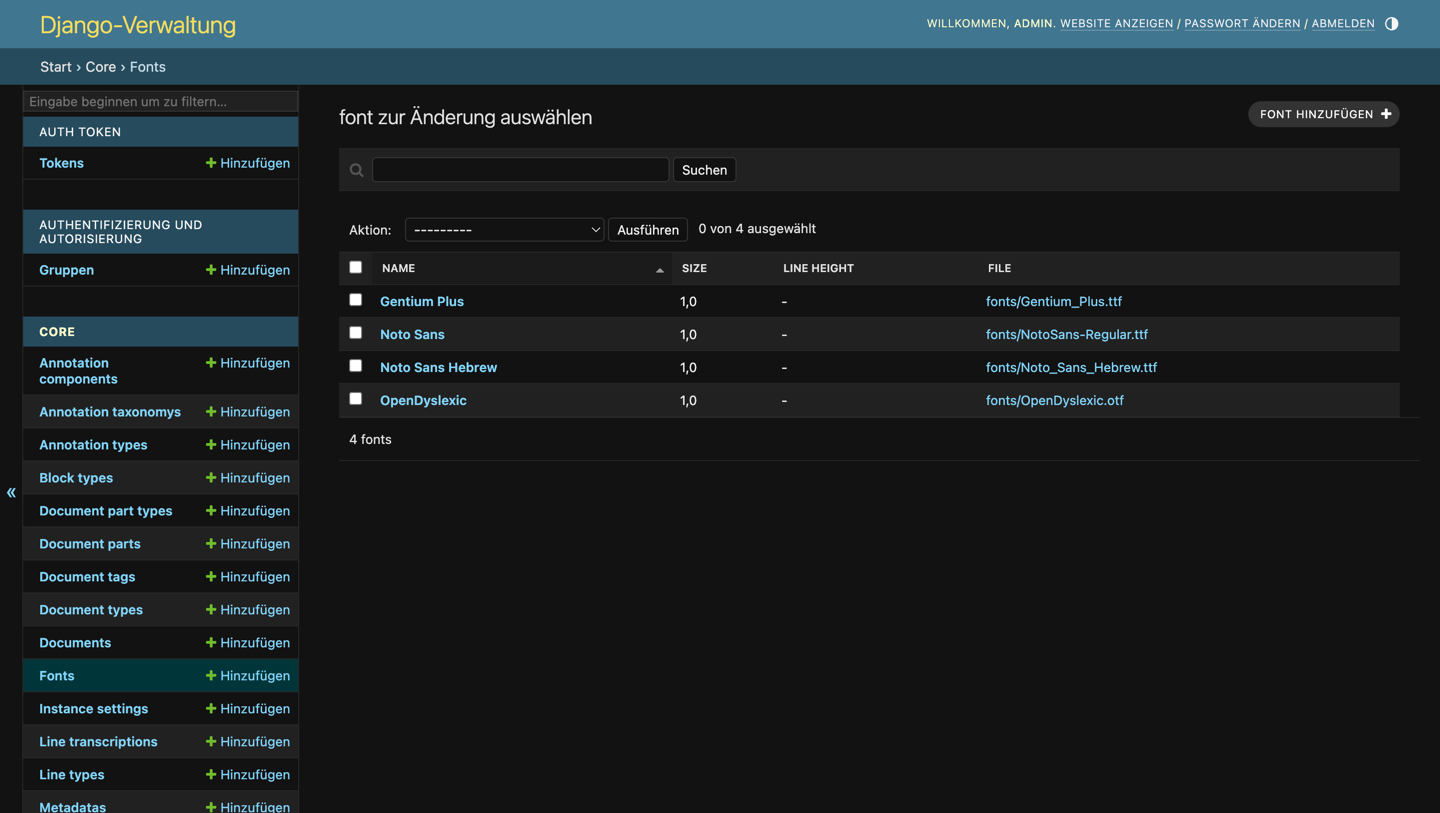
Im Django-Admin (unter „Core“) ist das Modell „Fonts“ aufgeführt. Es enthält alle der Instanz hinterlegten Schriftarten:
1.2. Eine neue Schriftart hinterlegen
Eine neue Schriftart wird über „Fonts“ → „Add“ angelegt:
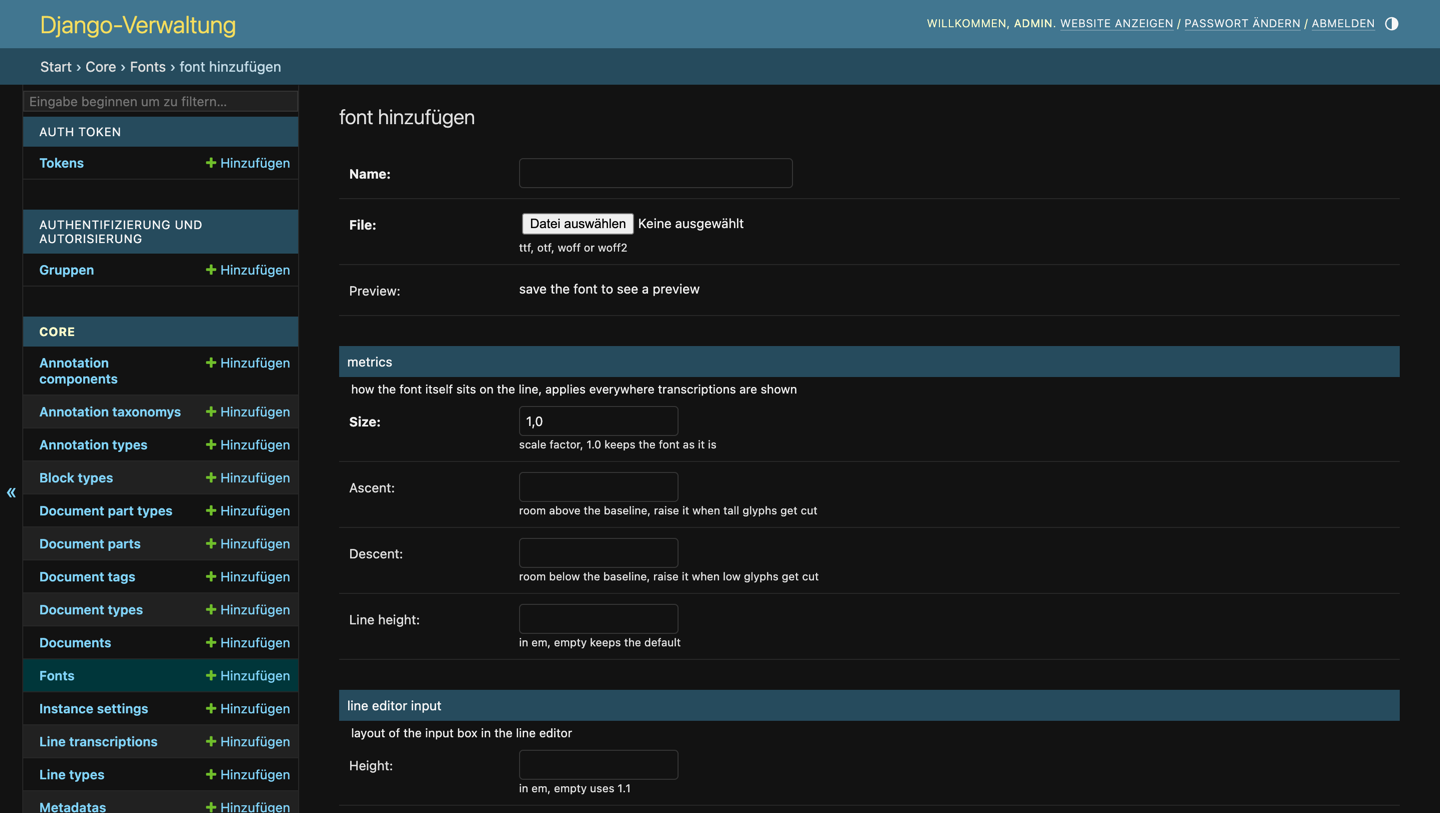
- Name: Der in den Auswahllisten der Benutzer angezeigte Name (z. B. „Noto Sans“).
- File: Die Schriftdatei im Format
ttf,otf,woffoderwoff2. - Preview: Zeigt nach dem Speichern die gewählte Schrift in einer Beispielzeile an.
- Metrik (metrics): Steuert, wie die Schrift selbst auf der Zeile sitzt und überall dort wirkt, wo Transkriptionen angezeigt werden. Size ist ein Skalierungsfaktor (1.0 belässt die Schrift unverändert), Ascent den Abstand über der Grundlinie (erhöhen, wenn hohe Zeichen abgeschnitten werden), Descent den Abstand unter der Grundlinie (erhöhen, wenn tiefe Zeichen abgeschnitten werden) und Line height den Zeilenabstand in em (leer lässt den Standard).
- Eingabefeld der Zeilenansicht (line editor input): Steuert die Gestaltung des Eingabefelds in der Zeilenansicht (Höhe, Innenabstände oben/unten, Außenabstände oben/unten und vertikale Ausrichtung), jeweils in em; leere Werte lassen die jeweiligen Standardwerte gelten.
Nach dem Speichern steht die Schriftart allen Benutzern in den Auswahllisten zur Verfügung.
1.3. Standard-Schriftarten der Instanz
Die Instanz der UB Mannheim stellt die Transkriptionsschriftarten Gentium Plus, Noto Sans, Noto Sans Hebrew, Hebrew-Samaritan (Schrift für die samaritanische Schrift, von Yoram Gnat, erstellt mit FontForge 2.0, lizenziert unter GPL 2), OpenDyslexic und Abyssinica (Schrift für äthiopische Schriften) vor. Die Schriftdateien können über die oben beschriebene Funktion im Django-Admin nachinstalliert oder aktualisiert werden; eine vorhandene Schriftart (erkannt am Namen) wird nicht doppelt angelegt, sondern übersprungen.
2. Benutzer einladen
Neue Benutzer werden über Einladungen per E-Mail registriert: Der Empfänger erhält eine E-Mail mit einem Link, über den er sein Konto anlegt (Login, E-Mail-Adresse, Vor- und Nachname, Passwort). Die Einladeseite ist für alle Benutzer sichtbar, die die Berechtigung „Benutzer einladen“ (can_invite) haben – dazu zählen in der Regel Administrator:innen; sie kann über das Benutzermenü oben rechts unter „Einladen“ geöffnet werden.
2.1. Einzelne Einladung
Im Modus „Einzeln“ geben Sie die Angaben zum Empfänger ein: E-Mail-Adresse, optional Vor- und Nachname sowie optional das Team (Gruppe), in das der Benutzer nach der Registrierung aufgenommen werden soll, und ein optionales Ablaufdatum für das Konto. Mit „Absenden“ wird die Einladungsmail verschickt.
2.2. Massenversand
Im Modus „Massenversand“ können mehrere Einladungen auf einmal versendet werden: Entweder wird eine CSV-Datei mit einer E-Mail-Adresse pro Zeile hochgeladen oder die Adressen werden direkt eingegeben (eine pro Zeile, optional in der Form „Vorname Nachname
Versendete Einladungen (mit Empfänger, Team und Status) können über das Benutzermenü unter „Profileinstellungen“ → „Einladungen“ eingesehen werden.
3. API-Token und REST-API
eScriptorium stellt eine REST-API (DRF) bereit, mit der sich Projekte, Dokumente, Transkriptionen, Bilder, Annotationen, Modelle, Schriftarten und mehr per HTTP verwalten lassen. Jeder Benutzer besitzt einen persönlichen API-Token:
- Den Token finden Sie unter „Profileinstellungen“ → „API-Schlüssel“; die Buttons daneben kopieren ihn in die Zwischenablage bzw. erzeugen einen neuen Token (der alte wird dabei ungültig).
- Autorisiert wird mit dem Header
Authorization: Token <token>; die Seite zeigt eincurl-Beispiel.
Die API ist selbst dokumentiert (OpenAPI): Unter /api/schema/ liegt das Schema, /api/swagger/ die interaktive Swagger-UI und /api/redoc/ eine ReDoc-Darstellung.
4. Web-Statistik (Matomo)
Die Instanz der UB Mannheim bietet – als Erweiterung gegenüber dem Standard-Release, die derzeit als Pull Request für die Standardversion vorgeschlagen ist – eine optionale Web-Statistik auf Basis von Matomo. Die Auswertung wird auf Instanzebene konfiguriert und betrifft die gesamte Oberfläche (also auch Seiten ohne Login); die Einbindung respektiert dabei die ortsbezogene Datenschutzkonfiguration.
- Die Statistik wird durch die Variablen
MATOMO_URL(URL der Matomo-Instanz, z. B.https://ub-monitor.bib.uni-mannheim.de/matomo/) undMATOMO_SITE_ID(die Kennung des betroffenen Matomo-Projekts) aktiviert. - Sind beide Werte gesetzt, fügt eScriptorium das Matomo-Skript in jede Seite ein; bleiben sie leer, wird keine Statistik geladen.
- So lässt sich die Nutzung der Instanz (Seitenaufrufe, Klicks) anonymisiert auswerten, ohne dass eine Analyse-Drittanbieterdatenbank kontaktiert wird.
5. Wartungsbefehle (manage.py)
Für den Betrieb stellt eScriptorium eine Reihe von Django-Verwaltungsbefehlen zur Verfügung, die als manage.py <Befehl> [Optionen] ausgeführt werden. In der Container-Installation (docker-compose) werden sie in den App-Containern (z. B. web) mit docker compose exec web python manage.py <Befehl> [Optionen] ausgeführt. Befehle, die eine geplante, regelmäßige Ausführung voraussetzen, sind im Folgenden entsprechend markiert.
5.1. cleanup_expired_downloads
Entfernt abgelaufene Download-Dateien: Zuerst die Datei auf der Platte, dann die Datenbankzeile. Downloads ohne Ablaufdatum werden nicht berührt. Der Befehl ist idempotent und sicher wiederholt ausführbar.
--dry-run– zeigt nur an, was gelöscht würde, ohne etwas zu ändern.- Geplante Ausführung (z. B. täglich um 03:15 Uhr):
15 3 * * * cd /srv/app && python manage.py cleanup_expired_downloads
5.2. cleanup_ghost_tasks
Markiert TaskReports als abgestürzt, deren Celery-Aufgabe nicht mehr existiert: „Laufende“ Berichte, deren Prozess nicht mehr läuft, sowie „In der Warteschlange“-Berichte, deren Aufgabe weder in einer Queue noch bei einem Worker zu finden ist (z. B. weil die Nachricht konsumiert, aber verloren ging).
--min-age SEKUNDEN– räumt nur „In der Warteschlange“-Berichte aus, die mindestens so alt sind (Standard: 60 Sekunden).--verbosity {1,2,3,4}– Steuerung der Protokollierung (ERROR/WARNING/INFO/DEBUG).- Funktioniert nur, wenn die Worker und der Redis-Broker erreichbar sind; ist das nicht der Fall, wird nichts gelöscht (um laufende Aufgaben nicht fälschlich als abgestürzt zu markieren).
- Geplante Ausführung, z. B. stündlich.
5.3. check_quotas
Schickt Benutzern, die ihre Kontingente (Speicherplatz, CPU-Minuten oder GPU-Minuten) erschöpft haben, eine E-Mail. Pro Benutzer und Kontingent wird innerhalb von QUOTA_NOTIFICATIONS_TIMEOUT Tagen (Standard: 3) nicht erneut geschrieben. Läuft auf Instanzen, bei denen Kontingente deaktiviert sind (DISABLE_QUOTAS), leer.
- Geplante Ausführung, z. B. täglich.
5.4. index
Erzeugt die Volltextsuche (Elasticsearch/OpenSearch): Es wird je Transkriptionszeile ein Suchdokument angelegt. Damit lässt sich nach dem Anlegen neuer Inhalte, nach Berechtigungsänderungen oder nach Problemen mit der Suche neu indizieren.
--project-pks PK [PK ...]– nur die angegebenen Projekte indizieren (Standard: alle).--document-pks PK [PK ...]– nur die angegebenen Dokumente indizieren.--part-pks PK [PK ...]– nur die angegebenen Dokumentteile indizieren.--drop– vorhandenen Index vor dem Neuanlegen löschen (z. B. bei Konflikt des Index-Mappings).- Voraussetzungen:
DISABLE_ES_SEARCHmuss aufFalsegesetzt sein und der alsES_SEARCH_URLdefinierte Host muss erreichbar sein.
5.5. qualify_models
Stellt Architekturqualifikations-Aufgaben für OCR-Modelle in die Celery-Warteschlange; damit lassen sich Modelle (neu)qualifizieren, falls die dafür vorgesehene Datenmigration den Broker nicht erreicht hat.
--all– auch Modelle, die bereits eine Architektur besitzen, erneut qualifizieren (Standard: nur Modelle ohne Architektur).
5.6. cleanup_models_versioning
Entfernt aus der Modellversionierung (Versionshistorie) alles, was älter als MODELS_VERSION_RETENTION Tage (Standard: 30) ist. Ist MODELS_VERSION_RETENTION auf 0 gesetzt, wird nichts gelöscht.
--dry-run– gibt nur die Anzahl betroffener Modelle aus, ohne Datei- oder Datenbankänderungen.- Geplante Ausführung, z. B. täglich.
5.7. cleanup_orphan_models
Räumt Modellreste auf: Es werden OcrModel-Zeilen ohne zugehörige Datei sowie Modellverzeichnisse unter MEDIA_ROOT/models gelöscht, auf die kein OcrModel mehr verweist. Modelle, bei denen das Training-Flag gesetzt ist, werden trotz fehlender Datei behalten (möglicherweise ein steckendes Training). Zum Schluss werden Modelle gemeldet, die auf eine nicht vorhandene Datei verweisen (Warnung, keine Löschung).
--dry-run– gibt nur aus, was aufgeräumt würde, ohne Datei- oder Datenbankänderungen.- Geplante Ausführung, z. B. wöchentlich.
5.8. calculate_avg_confidences
Berechnet die durchschnittliche Zeichen-Confidence für alle vorhandenen OCR-/HTR-Zeilen (mit Confidence-Werten), die durchschnittliche Zeilen-Confidence für Transkriptionen und – auf Dokumentteil-Ebene – die jeweils höchste Durchschnittsconfidence der zugehörigen Transkriptionen. Für neue Transkriptionen erfolgt das automatisch; der Befehl dient dazu, die Felder für bereits existierende Datensätze zu befüllen.
--batch-size N– Batch-Größe für die Verarbeitung (Standard: 1000).
5.9. Standard-Django-Befehle
Neben den eScriptorium-spezifischen Befehlen sind für den Betrieb und vor allem für Updates einige allgemeine Django-Befehle erforderlich. Für lokale Installationen (ohne Container) sind sie mit der Option --settings escriptorium.local_settings zu ergänzen, wie in der Installationsanleitung gezeigt.
migrate– wendet Änderungen am Datenbankschema an (neue oder geänderte Tabellen). Nach einem eScriptorium-Update erforderlich; bei der Container-Installation führt das Startskript (entrypoint.sh) den Befehl bei jedem Start des Web-Containers automatisch aus.makemessages --allundcompilemessages– aktualisieren bzw. kompilieren die Übersetzungen der Benutzeroberfläche (siehe Installationsanleitung, Abschnitt 13). Bei der Container-Installation sind die Kataloge bereits beim Bau des Images kompiliert, so dass im Normalfall nichts zu tun ist.collectstatic --no-input– sammelt die statischen Dateien (CSS, JavaScript, Bilder) zusammen; wird vom Web-Container ebenfalls automatisch beim Start ausgeführt. Nach einem Update, bei dem sich Frontend-Dateien geändert haben, empfiehlt sichcollectstatic --no-input --clear, damit keine veralteten Dateien zurückbleiben (das eScriptorium-Repository stellt dafür das Skriptscripts/refresh-frontend.shbereit, das zusätzlich das Image neu baut und die Container neu startet).check– führt Konfigurations- und Installationsprüfungen durch (sinnvoll vor und nach einem Update).createsuperuser– legt ein weiteres Administrator-Konto an.
6. Celery-Queues und Worker
Die asynchronen Aufgaben (Segmentierung, Transkription, Training, Thumbnails, E-Mails usw.) werden über Celery mit Redis als Broker ausgeführt. Die Aufgaben sind auf mehrere Queues verteilt, damit kurzlaufende, für die Oberfläche wichtige Vorgänge nicht durch lange Berechnungen blockiert werden und unterschiedliche Anforderungen (CPU, GPU, Java) jeweils eigene Worker nutzen können.
6.1. Die Queues
| Queue | Verwendung | Typische Aufgaben |
|---|---|---|
default | Standard-Queue (alle Aufgaben ohne eigene Zuordnung) | Segmentierung, Transkription, Konvertierung, Komprimierung |
live | Aufgaben, die für die Oberfläche sofort erledigt sein sollen | Neuberechnung von Masken |
low-priority | Weniger zeitkritische Aufgaben | Thumbnails, Modellqualifizierung, Importe, asynchrone E-Mails |
gpu | Aufgaben, die eine (oder am besten eine) GPU nutzen | Training, SegTrain |
jvm | Aufgaben, die eine Java-Laufzeitumgebung benötigen (außer Elasticsearch) | Textalignierung |
intensive-inference | Inferenz, die rechenintensiv genug ist, um auf eine eigene Worker zu gehören (z. B. D-FINE-Modelle) | Segmentierung/Transkription mit entsprechend qualifizierten Modellen |
Die Zuordnung der Aufgaben zu Queues ist in settings.py (CELERY_TASK_ROUTES) festgelegt; die Queue intensive-inference wird dynamisch pro Aufruf vergeben, sobald das verwendete Modell zur in INTENSIVE_INFERENCE_MODEL_ARCHITECTURES aufgeführten Architektur zählt (Standard: DFINEModel).
6.2. Worker in der Container-Installation
Die mitgelieferte docker-compose.yml startet für die meisten Queues je einen eigenen Worker-Service:
| docker-compose-Service | Queue | Standard-Parallelität |
|---|---|---|
celery-main | default | CELERY_MAIN_CONC (Standard: 10) |
celery-live | live | CELERY_LIVE_CONC (Standard: 10) |
celery-low-priority | low-priority | CELERY_LOW_CONC (Standard: 10) |
celery-gpu | gpu | 1 |
celery-intensive-inference | intensive-inference | 1 |
Die Parallelität lässt sich über die genannten Umgebungsvariablen (bzw. die Option -c der Worker) einstellen. Der GPU-Worker läuft standardmäßig auf CPU (KRAKEN_TRAINING_DEVICE=cpu); celery-intensive-inference ebenfalls (KRAKEN_INFERENCE_DEVICE=cpu) – die Variable kann auf eine vorhandene GPU umgestellt werden.
Hinweis zur Queue jvm: Die docker-compose.yml enthält keinen Worker für die Queue jvm, sodass dort geroutete Aufgaben (derzeit: Textalignierung) nicht ausgeführt werden, solange kein eigener Worker hinzugefügt wird. Für die Textalignierung ist entsprechend ein Worker (bzw. ein Java-Umgebung tragender Container) vorzusehen.
6.3. Kontingente und Queues
Ob eine Aufgabe gegen die GPU-Kontingente angerechnet wird, richtet sich nach ihrer Queue: Aufgaben aus gpu und intensive-inference zählen als GPU-Nutzung, alles andere als CPU-Nutzung. Wer also Queues umkonfiguriert oder neue hinzufügt, sollte die GPU-Kontrollen in den betroffenen Aufgaben (reporting/tasks.py) entsprechend mit anpassen.
6.4. Lokale (nicht containerisierte) Installation
Die Installationsanleitung startet nur einen einfachen Worker, der standardmäßig die Queue default bedient:
DJANGO_SETTINGS_MODULE=escriptorium.local_settings celery -A escriptorium worker -l INFO &
Damit reicht es für Testzwecke (Segmentierung, Transkription); Training, Alignierung und die übrigen Queues werden nicht bedient. Für eine vollständige lokale Umgebung müssten für die weiteren Queues eigene Worker (z. B. mit -Q live, -Q low-priority, -Q gpu, -Q jvm, -Q intensive-inference) gestartet werden.